
مدل جِو؛ موتور تصمیمگیری ساختاریافته با سرعت ۲۰۰ برابر چتجیپیتی، بدون تولید متن
مدلهای زبانی بزرگی مانند چتجیپیتی (ChatGPT) و کلاد (Claude) در نوشتن، تحلیل، استدلال و برنامهنویسی توانایی چشمگیری دارند؛ اما انتقال همین توانایی به بکاند نرمافزارها، سامانههای سازمانی و اتوماسیونهای پرتعداد همیشه به نتیجه مطلوب نمیرسد. تأخیر چندثانیهای، هزینه سنگین توکنهای خروجی، تولید پاسخهای بیشازحد طولانی و احتمال تخریب ساختار مورد انتظار بر اثر توهم، از جمله مشکلاتی هستند که در کاربردهای عملی و بلادرنگ نمایان میشوند.
جِو (Jev) برای حل همین مسئله طراحی شده است. این مدل بهجای آنکه مانند یک چتبات حرف بزند، توضیح بنویسد یا متن آزاد تولید کند، نقش یک موتور تصمیمگیری ساختاریافته را بر عهده میگیرد. ادعای اصلی درباره آن، سرعتی تا ۲۰۰ برابر بیشتر از مدلهای زبانی متعارف، خروجی عددی و ساختاریافته، نبود هزینه برای توکن خروجی و امکان ارزیابی همزمان تعداد زیادی پرسش است.
این رویکرد را دیگو آلمیدا (Diego Almeida)، پژوهشگر سابق اوپنایآی (OpenAI) که در آموزش چتجیپیتی نیز مشارکت داشته، به همراه تیمش معرفی کرده است. جِو قرار نیست جای چتجیپیتی یا کلاد را بگیرد؛ بلکه برای آن بخش از سامانههای هوشمند ساخته شده که بهجای مکالمه و تولید محتوا، به تصمیم سریع، طبقهبندی دقیق، امتیازدهی، مسیریابی و انتخاب میان گزینههای از پیش تعریفشده نیاز دارند.
مشکل اصلی مدلهای زبانی در اتوماسیون چیست؟
از سال ۲۰۲۲ به بعد، بخش عمده صنعت هوش مصنوعی بر بهینهسازی مدلها برای گفتوگو با انسان یا فعالیت بهعنوان عاملهای برنامهنویسی متمرکز بوده است. مدل زبانی بزرگ (Large Language Model یا LLM) معمولاً پاسخ خود را بهصورت خودبازگشتی (Autoregressive) میسازد؛ یعنی توکنها را یکی پس از دیگری تولید میکند و هر توکن جدید بر پایه توکنهای قبلی حدس زده میشود.
این روش برای نگارش مقاله، پاسخگویی مکالمهای، تولید کد یا توضیح مفاهیم بسیار مفید است، اما همه فرایندهای نرمافزاری به متن آزاد احتیاج ندارند. برای مثال، اگر هدف فقط تعیین دپارتمان مسئول یک ایمیل، تشخیص احتمال کلاهبرداری، ارزیابی سطح ریسک یا انتخاب مسیر بعدی یک درخواست باشد، تولید چند جمله فارسی یا انگلیسی نهتنها ضروری نیست، بلکه سرعت را پایین میآورد و هزینه را افزایش میدهد.
شرکت تایپسیف ایآی (TypeSafe AI) برای توضیح این تفاوت از یک تشبیه استفاده میکند: واداشتن یک چتبات به تصمیمگیری درون کد، مانند بردن یک کامیون بنزینی به پیست مسابقه است. کامیون ممکن است قدرتمند باشد، اما برای سرعت و چابکی مسابقه طراحی نشده است. به همین ترتیب، یک مدل مکالمهای میتواند تصمیم درست را پیدا کند، ولی برای رسیدن به یک پاسخ ساده ناچار است فرایند پرهزینه تولید متن را طی کند.
خطر خطای زنجیرهای در تولید متوالی متن
در یک مدل متنی، پاسخ کامل بهصورت یک توالی ساخته میشود. اگر در توکنها یا واژههای ابتدایی یک برداشت نادرست شکل بگیرد، ادامه پاسخ نیز ممکن است بر همان فرض اشتباه بنا شود. برای نمونه، اگر مدل در سومین واژه یا گام استدلالی دچار خطای کوچکی شود، واژهها و استدلالهای بعدی میتوانند همان خطا را تقویت کنند. نتیجه، نوعی توهم زنجیرهای است که گاهی علاوه بر محتوای پاسخ، ساختار فنی مورد انتظار برنامه را هم به هم میریزد.
این مشکل زمانی جدیتر میشود که نرمافزار منتظر یک ساختار مشخص مانند جیسون (JSON) باشد. اضافهشدن یک توضیح ناخواسته، حذف یک نشانه، تغییر نام یک فیلد یا تولید گزینهای که در فهرست وجود ندارد، ممکن است کل مرحله بعدی اتوماسیون را متوقف کند. دریافت پاسخ کامل نیز بسته به مدل و میزان پردازش، گاهی چندین ثانیه یا حتی چند ده ثانیه طول میکشد.
جِو این چرخه را از اساس کنار میگذارد. مدل قرار نیست پاراگراف بنویسد یا پاسخ را کلمهبهکلمه بسازد. به همین دلیل، احتمال توهم متنی در معنای رایج آن حذف میشود؛ زیرا اصلاً متن آزادی وجود ندارد که مدل در میانه تولید آن از ساختار تعیینشده خارج شود.
جِو چگونه کار میکند؟
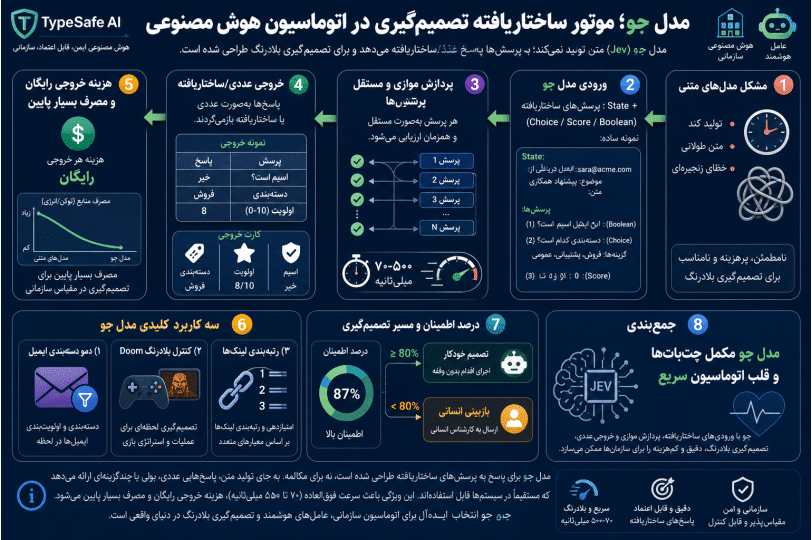
ورودی جِو از دو بخش اصلی تشکیل میشود: «حالت» یا استیت (State) و مجموعهای از پرسشهای مشخص. حالت میتواند متن یک ایمیل، دادههای فعلی یک برنامه، وضعیت یک بازی، اطلاعات یک مشتری یا هر دادهای باشد که تصمیم باید بر اساس آن گرفته شود.
پس از ارسال حالت، توسعهدهنده بهجای درخواست یک توضیح آزاد، چند پرسش دقیق تعریف میکند. این پرسشها در سه قالب پایه قرار میگیرند:
انتخاب یا چویس (Choice): مدل باید دقیقاً یک گزینه را از میان فهرستی از گزینههای از پیش تعیینشده برگزیند.
امتیاز یا اسکور (Score): مدل جایگاه داده را روی یک طیف یا معیار چندسطحی ارزیابی میکند و یک امتیاز عددی میدهد.
پاسخ دودویی یا بولی (Boolean): مدل میان بله و خیر، درست و نادرست یا صفر و یک تصمیم میگیرد و میزان اطمینان خود را نیز ارائه میدهد. در برخی نمایشهای رابط کاربری این قالب با عنوانی مانند «Null» دیده یا تلفظ شده، اما کارکرد توصیفشده همان ارزیابی بله یا خیر است.
مزیت مهم این معماری آن است که پرسشها مستقل از یکدیگر ارزیابی میشوند. پاسخ پرسش اول، مبنای اجباری پاسخ پرسش دوم نیست؛ بنابراین اگر ارزیابی یک پرسش اشتباه باشد، خطا لزوماً به تمام پرسشهای بعدی سرایت نمیکند. این تفاوت، احتمال شکلگیری توهم زنجیرهای را بهشدت کاهش میدهد.
جِو میتواند این ارزیابیها را بهصورت موازی انجام دهد. زمان اعلامشده برای پردازش مجموعه پرسشها حدود ۷۰ تا ۵۰۰ میلیثانیه است. در نتیجه، سامانه بهجای انتظار برای تولید جملهبهجمله پاسخ، مجموعهای از تصمیمها، امتیازها و احتمالهای کالیبرهشده را دریافت میکند.
چرا خروجی جِو رایگان اعلام شده است؟
در مدلهای زبانی معمولی، توکنهای خروجی ممکن است تا پنج برابر گرانتر از توکنهای ورودی باشند. علت این تفاوت آن است که مدل باید پاسخ را توکنبهتوکن تولید کند. حتی بخشهایی از فرایند که بهعنوان «فکرکردن» یا استدلال شناخته میشوند نیز میتوانند با تولید توکن همراه باشند.
جِو خروجی متنی ندارد. پاسخ نهایی تنها مجموعهای محدود از انتخابها، امتیازها و احتمالهای عددی است. سازندگان مدل به همین دلیل هزینه توکن خروجی را رسماً صفر در نظر گرفتهاند. هزینه ورودی نیز بسیار پایین اعلام شده است: ۴۲ سنت بهازای هر ۱۰ میلیون توکن ورودی.
این تفاوت قیمت زمانی اهمیت پیدا میکند که سامانه با هزاران یا میلیونها درخواست روبهرو باشد. شاید هزینه یک پاسخ متنی منفرد ناچیز به نظر برسد، اما در یک اتوماسیون پرتعداد، همان هزینه کوچک در تعداد درخواستها ضرب میشود. علاوه بر پول، زمان انتظار هر درخواست نیز بر توان عملیاتی کل سامانه اثر میگذارد.
آموزش با تصمیمهای کالیبره، نه صرفاً ترجیح انسانی
برای آموزش جِو، بهجای تکیه صرف بر روش متداول یادگیری تقویتی از بازخورد انسانی (Reinforcement Learning from Human Feedback یا RLHF)، از روشی با عنوان یادگیری تقویتی برای تصمیمهای کالیبره (Reinforcement Learning for Calibrated Decisions یا RLCD) استفاده شده است.
هدف این روش آن است که مدل همراه هر تصمیم، تصویری واقعبینانه از میزان اطمینان خود ارائه دهد و صرفاً یک ادعای قطعی و بیپشتوانه مطرح نکند. برای یک نرمافزار، تفاوت مهمی میان تصمیمی با اطمینان ۵۵ درصد و تصمیمی با اطمینان ۹۹ درصد وجود دارد. برنامه میتواند برای اطمینانهای پایین، مسیر بازبینی انسانی را فعال کند و تصمیمهای بسیار مطمئن را بهصورت خودکار ادامه دهد.
به این ترتیب، درصد اطمینان فقط یک عدد تزئینی نیست؛ بلکه میتواند بخشی از منطق عملیاتی سامانه باشد. مثلاً تیکتهایی با اطمینان بیش از ۹۵ درصد مستقیماً به دپارتمان مربوط فرستاده شوند، موارد بین ۷۰ تا ۹۵ درصد از یک مرحله کنترل دوم بگذرند و موارد زیر ۷۰ درصد برای بررسی انسانی نگه داشته شوند.
سه کاربردی که تفاوت جِو را آشکار میکنند
۱. دستهبندی هزاران ایمیل و تیکت پشتیبانی
فرض کنید یک سامانه پشتیبانی روزانه هزار ایمیل دریافت میکند. اگر یک مدل زبانی متعارف برای هر ایمیل متن را بخواند، استدلال کند و سپس پاسخی توضیحی تولید کند، حتی تأخیر سهثانیهای برای هر مورد میتواند زمان و هزینه قابلتوجهی ایجاد کند.
در معماری جِو، متن ایمیل بهعنوان حالت ارسال میشود و پرسشی انتخابی مانند این تعریف میشود: «این تیکت متعلق به کدام دپارتمان است؟» گزینهها نیز میتوانند «فنی»، «مالی» و «فروش» باشند. مدل بدون تولید توضیح اضافی، یکی از همین گزینهها را در چند میلیثانیه انتخاب میکند و درصد اطمینان خود را برمیگرداند.
چنین پاسخی مستقیماً در کد قابل استفاده است. برنامه لازم نیست متن مدل را تجزیه کند یا از میان چند جمله به دنبال نام دپارتمان بگردد. گزینه بازگشتی از ابتدا با ساختار سامانه هماهنگ است و میتواند بلافاصله تیکت را به صف مناسب منتقل کند.
۲. اجرای بلادرنگ بازی دوم
بازی دوم (Doom) نمونهای روشن از اهمیت تأخیر پایین است. تیم تایپسیف نمایشی منتشر کرده که در آن جِو کنترل بازی را بر عهده میگیرد. ساختار وضعیت بازی، شامل اطلاعاتی مانند میزان جان باقیمانده، موقعیت دشمن و سلاح در دسترس، در هر ثانیه ۱۰ بار بهشکل متنی برای مدل فرستاده میشود.
مدل همزمان چند پرسش را ارزیابی میکند: شخصیت باید به کدام سمت حرکت کند؟ آیا شلیک انجام شود؟ کدام اقدام در وضعیت فعلی مناسبتر است؟ پاسخهای موازی و سریع باعث میشوند عامل بتواند بازی را بهصورت بلادرنگ ادامه دهد و بلافاصله کشته نشود.
اجرای همین منطق با یک مدل مکالمهای معمولی دشوار است. اگر هر حرکت حدود سه ثانیه تأخیر داشته باشد، محیط بازی مدتها پیش از رسیدن پاسخ تغییر میکند و شخصیت احتمالاً در همان لحظات ابتدایی از بین میرود. جِو این آزمایش را با تأخیر کمتر از ۱۰۰ میلیثانیه انجام داده است. هزینه اعلامشده نیز حدود ۷ دلار در ساعت برای نرخ ۱۰ کوئری یا درخواست در هر ثانیه بوده است.
این آزمایش به آن معنا نیست که جِو یک هوش عمومی برای بازیکردن است. نکته اصلی، توانایی آن در دریافت وضعیت متغیر، ارزیابی همزمان چند تصمیم محدود و بازگرداندن پاسخ در بازه زمانی مناسب برای یک محیط زنده است.
۳. مسابقه ویکیپدیا و رتبهبندی صدها لینک
در ویکیریسینگ (Wiki Racing)، یک صفحه مبدأ و یک صفحه مقصد در ویکیپدیا (Wikipedia) وجود دارد. بازیکن باید با کلیک روی لینکهای صفحه مبدأ، ورود به صفحات بعدی و ادامه همین مسیر، در کوتاهترین زمان یا با کمترین تعداد گام به صفحه مقصد برسد.
هر صفحه ممکن است صدها لینک داشته باشد. قرار دادن چنین فهرستی مقابل یک مدل زبانی میتواند حجم توکن را بهسرعت افزایش دهد. مدل همچنین ممکن است لینکی را پیشنهاد کند که در صفحه وجود ندارد یا نامی خیالی بسازد. حتی اگر پاسخ درست باشد، تولید توضیح درباره هر لینک زمانبر خواهد بود.
جِو نیازی به نوشتن حتی یک کلمه ندارد. مدل میتواند لینکها را بهصورت موازی امتیازدهی و رتبهبندی کند و گزینهای را که احتمال بیشتری برای نزدیککردن مسیر به مقصد دارد، در اولویت قرار دهد. در اینجا نیز مزیت اصلی از محدودکردن مسئله به تصمیم و امتیاز ناشی میشود، نه از تلاش برای ساخت یک پاسخ روایی.
جِو جایگزین چتباتها نیست؛ یک «اگر» هوشمند است!
بهترین تعریف برای جِو، یک عبارت شرطی یا «اگر» هوشمند، سریع و انعطافپذیر است. عبارتهای شرطی معمولی فقط قواعدی را اجرا میکنند که برنامهنویس از قبل نوشته است؛ مثلاً اگر مبلغ از عدد مشخصی بیشتر بود، درخواست به واحد خاصی برود. اما در بسیاری از دادههای انسانی، قواعد صریح کافی نیستند. تشخیص لحن ایمیل، نوع درخواست، سطح حساسیت یا احتمال سوءاستفاده با چند شرط ثابت بهسادگی ممکن نیست.
جِو این فاصله را پر میکند. مدل میتواند داده غیرساختاریافته را بخواند و نتیجهای ساختاریافته تحویل دهد. با این حال، برای گفتوگو، نگارش، توضیح مفصل، ایدهپردازی یا تولید کد همچنان مدلهایی مانند چتجیپیتی و کلاد مناسبترند.
مدلهای این دسته، از جمله جِو و نمونههای مشابه چینی که بنا بر گزارش ارائهشده حتی با سرعت بیشتر و هزینه کمتر همان کار را انجام میدهند، رقیب مستقیم چتباتها نیستند. کاربرد اصلی آنها در بعضی از عاملهای هوش مصنوعی، نه همه عاملها، و بهویژه در تصمیمگیری، طبقهبندی و مسیریابی است.
ترکیب این دو خانواده میتواند بازدهی بالایی ایجاد کند: یک مدل تصمیمگیری سریع، دادهها را دستهبندی کند و مسیر را برگزیند؛ سپس فقط در مواردی که واقعاً به تولید یا استدلال متنی نیاز است، یک مدل زبانی بزرگ فراخوانی شود. تا پیش از ظهور چنین ابزارهایی، سازندگان عاملها ناچار بودند حتی برای تصمیمهای ساده از مدلهای متنی استفاده کنند. این در حالی است که فرایندهای عاملمحور به سرعت بالا و هزینه پایین نیاز دارند.
دسترسی به جِو از طریق تایپسیف
سادهترین مسیر برای آزمایش مدل، وبسایت هوش مصنوعی جو است. دسترسی از حالت فهرست انتظار خارج شده و با ایجاد حساب کاربری میتوان وارد پنل شد. در پنل، بخشی با عنوان پلیگراند (Playground) برای آزمایش تعاملی مدل و بخشی برای ساخت رابط برنامهنویسی کاربردی یا ایپیآی (API) وجود دارد.
پلیگراند نمونهای با ساختار جیسون نمایش میدهد، اما استفاده از جیسون اجباری نیست. حالت ورودی را میتوان بهصورت متن ساده نیز فرستاد. ساختار جیسون بیشتر برای پروژههای ماشینی، اتوماسیونها و تبادل منظم چند فیلد سودمند است.
برای کار با مدل، ابتدا حالت در قسمت ورودی نوشته میشود و سپس پرسشها در یکی از سه قالب انتخاب، پاسخ دودویی یا امتیازدهی ساخته میشوند. هر پرسش یک نام یا نام فیلد، نوع و یک دستور دارد. در نوع انتخابی، فهرست گزینهها نیز باید تعیین شود.
یک آزمایش فارسی با سه نوع پرسش
پشتیبانی از زبان فارسی را میتوان با یک ورودی بسیار ساده بررسی کرد:
«اسم من مهدی است.»
این جمله حالت یا ورودی مدل است. سپس سه پرسش متفاوت درباره آن تعریف میشود.
پرسش انتخابی
برای پرسش نخست، نوع «انتخاب» تعیین میشود. نام فیلد میتواند «انتخابی» باشد و دستور چنین نوشته شود:
«این داده چه چیزی را مشخص میکند؟»
سه گزینه نمونه عبارتاند از:
سن
نام خانوادگی
اسم
مدل باید دقیقاً یکی از این سه گزینه را انتخاب کند. با توجه به جمله ورودی، پاسخ درست «اسم» یا همان گزینه سوم است. امکان افزودن پنج، ده، صد یا هر تعداد گزینه مورد نیاز نیز وجود دارد؛ مشروط بر آنکه گزینهها با قالب مورد انتظار رابط هماهنگ باشند.
پرسش بله یا خیر
پرسش دوم میتواند در قالب صفر و یک تعریف شود. برای نمونه:
«آیا این داده مربوط به اطلاعات فردی یک شخص است؟»
در این قالب، پاسخ میان درست و نادرست انتخاب میشود. مقادیر بازگشتی را میتوان بهشکل «آره» و «نه»، «True» و «False» یا حتی یک و صفر تنظیم کرد. انتخاب نمایش نهایی به نیاز برنامه بستگی دارد.
پرسش امتیازی و طیفی
برای پرسش سوم، نوع امتیاز انتخاب میشود:
«این داده تا چه اندازه شخصی است؟»
طیف نمونه میتواند سه سطح داشته باشد:
اصلاً جزو اطلاعات شخصی نیست.
اطلاعات شخصی است، اما بسیار خصوصی نیست.
اطلاعات کاملاً خصوصی افراد محسوب میشود و دیگران نباید آن را بدانند.
این گزینهها یک طیف میسازند و مدل باید جایگاه داده را روی آن تعیین کند. توسعهدهنده میتواند بهجای سه سطح، تعداد بیشتری سطح یا یک بازه متناسب با کاربرد خود تعریف کند.
نتیجه آزمایش و مفهوم «اطمینان»
پس از اجرای این مجموعه، جِو برای پرسش انتخابی گزینه سوم، یعنی «اسم»، را انتخاب میکند و میزان اطمینان را ۱۰۰ درصد نشان میدهد. برای پرسش دوم نیز پاسخ «بله» با اطمینان ۹۶ درصد بازگردانده میشود؛ یعنی مدل جمله را اطلاعات فردی شخص میداند.
در پرسش طیفی، پاسخ نمونه حدود ۱٫۰۲ گزارش شده و اطمینان آن ۹۵ درصد است. برای درک این عدد باید شیوه شمارهگذاری سطحها را دانست. سطحهای امتیازی از صفر آغاز میشوند، نه از یک. بنابراین اگر سه گزینه وجود داشته باشد، مقدارهای پایه آنها صفر، یک و دو خواهند بود. اگر ۱۰ سطح تعریف شود، طیف از صفر تا ۹ ادامه مییابد.
در مثال سهسطحی، امتیاز ۱٫۰۲ تقریباً روی سطح دوم قرار میگیرد: «اطلاعات شخصی است، اما خیلی خصوصی نیست.» عدد اعشاری نشان میدهد ارزیابی الزاماً به نقاط صحیح محدود نشده و مدل میتواند جایگاهی میان سطوح ارائه کند. در کنار آن، تعداد سطحهای تعریفشده و درصد اطمینان نیز نمایش داده میشود.
این شیوه برای ارزیابیهایی مانند شدت فوریت، میزان خطر، احتمال تقلب، درجه محرمانگی، تناسب یک محتوا یا کیفیت یک سرنخ فروش مناسب است. نکته مهم آن است که ترتیب گزینهها باید منطقی باشد؛ زیرا مدل آنها را بهعنوان یک طیف پیوسته تفسیر میکند.
استفاده از ورودی جیسون
اگرچه متن ساده کار میکند، داده جیسون برای نرمافزارها و عاملها ساختاریافتهتر است. همان جمله فارسی را میتوان در فیلدی مانند «جمله» قرار داد؛ یعنی داده شامل نام متغیر و مقدار آن باشد. این ساختار بهویژه زمانی مفید است که ورودی چند مؤلفه داشته باشد، مانند نام مشتری، متن درخواست، زمان ثبت، مبلغ تراکنش و کشور مبدأ.
برای آزمایشی دیگر، مقدار جمله از «اسم من مهدی است» به «سن من ۱۰ سال است» تغییر میکند. پس از اجرای دوباره، مدل در پرسش انتخابی گزینه مربوط به «سن» را با اطمینان ۱۰۰ درصد انتخاب میکند. در پرسش صفر و یک نیز با اطمینان ۹۶ درصد میگوید داده جزو اطلاعات فردی است. امتیاز طیفی دوباره نزدیک سطح «شخصی، اما نه بسیار خصوصی» قرار میگیرد.
این آزمایشها سادهاند و پیچیدگی فنی بالایی ندارند، اما هدف آنها نشاندادن سه نکته است: مدل ورودی فارسی را میفهمد، به گزینههای تعیینشده پایبند میماند و برای هر تصمیم میزان اطمینان ارائه میدهد.
ساخت کلید ایپیآی و اتصال به پروژهها
برای استفاده عملی، میتوان در پنل تایپسیف یک کلید ایپیآی ساخت. پس از انتخاب گزینه ایجاد کلید و تعیین نام، یک کلید اختصاصی نمایش داده میشود که باید کپی و با رعایت اصول امنیتی در پروژه نگهداری شود.
شیوه ارسال درخواست، تعریف حالت و پرسشها و دریافت پاسخ در مستندات تایپسیف توضیح داده شده است. توسعهدهنده میتواند مستندات را مستقیماً مطالعه کند یا نشانی آن را در اختیار یک دستیار هوش مصنوعی قرار دهد و از آن بخواهد روش اتصال تایپسیف به عامل، کد یا اتوماسیون مورد نظر را استخراج و پیادهسازی کند. سپس با افزودن کلید ساختهشده، فراخوانی مدل در پروژه امکانپذیر میشود.
این اتصال میتواند در کد اختصاصی، سامانههای سازمانی یا ابزارهای اتوماسیون مانند اِناِیتاِن (n8n) انجام شود. البته کلید محرمانه نباید در محیط عمومی یا متنهایی قرار گیرد که امکان افشای آنها وجود دارد.
هزینهای در حد چند دههزارم دلار
پنل تایپسیف بخشی برای مشاهده میزان مصرف دارد و میتوان مصرف ساعت اخیر یا بازههای دیگر را بررسی کرد. در آزمایش توصیفشده، مجموع دو درخواست حدود ۰٫۰۰۰۲ دلار، یعنی دو دههزارم دلار هزینه داشته است. دادههای آزمایش بسیار کوتاه و ساده بودهاند، اما همین عدد نشان میدهد هزینه پردازش ورودی در مقایسه با بسیاری از فراخوانیهای متنی بسیار پایین است.
از آنجا که هزینهای برای تولید خروجی متنی وجود ندارد، بخش اصلی صورتحساب به پردازش ورودی مربوط میشود. این ساختار قیمتگذاری همراه با سرعت بالا، جِو را برای فرایندهای پرتعداد و عاملمحور جذاب میکند.
آیا با چنین مدل محدودی میتوان کار پیچیده انجام داد؟
جِو برای تولید متنهای پیچیده یا انجام مستقل همه مراحل یک پروژه ساخته نشده است. با این حال، محدودبودن قالب پاسخ به معنای کمقدرتبودن آن نیست. اگر پرسشها و گزینهها هوشمندانه طراحی شوند، مجموعه آنها میتواند رفتاری شبیه یک الگوریتم تصمیمگیری انعطافپذیر ایجاد کند.
برای مثال، یک ورودی میتواند همزمان با دهها پرسش ارزیابی شود: نوع درخواست چیست؟ فوریت آن چقدر است؟ آیا داده حساس دارد؟ احتمال تقلب چقدر است؟ آیا به تأیید انسانی نیاز دارد؟ کدام تیم باید آن را بررسی کند؟ آیا پاسخ خودکار مجاز است؟ آیا لازم است یک مدل زبانی بزرگ برای نگارش پاسخ فراخوانی شود؟
ترکیب تعداد زیادی پرسش و گزینه، خروجی را بهشدت شخصیسازی میکند. سپس یک برنامه معمولی یا مدل دیگر میتواند بر پایه این خروجیها اقدام مناسب را انجام دهد. بنابراین قدرت جِو نه در یک پاسخ منفرد، بلکه در طراحی هوشمند شبکه تصمیمها آشکار میشود.
افرادی که تجربه ساخت عاملهای هوش مصنوعی، گردشکارهای عاملمحور یا پلتفرمهای سازمانی مبتنی بر هوش مصنوعی دارند، بهتر میتوانند ارزش این مدل را درک کنند. بسیاری از گلوگاههای چنین سامانههایی نه تولید متن، بلکه تصمیمهای کوچک، پرتکرار و وابسته به زمینه هستند؛ دقیقاً همان جایی که سرعت و قیمت جِو اهمیت پیدا میکند.
منابع آموزشی و جامعههای مکمل
در کنار معرفی جِو، مجموعهای از جامعهها و منابع آموزشی مرتبط با هوش مصنوعی نیز ارائه شده است. یک وبسایت آموزشی با ساختاری شبیه «اسکول» اخبار، مطالب و مقالههای هوش مصنوعی را منتشر میکند. اخبار برگرفته از منابع معتبر و فعالان حوزه هوش مصنوعی، به کمک عاملهای هوشمند بهطور خودکار به فارسی ترجمه و خلاصه میشوند و در اختیار مخاطبان قرار میگیرند.
بخشی دیگر شامل مقالههای آموزشی تولیدشده با عاملهای هوش مصنوعی است. تأکید شده که این مطالب صرفاً بازنشر نوشتههای تکراری نیستند و موضوعات کاربردی و تازهای را پوشش میدهند.
جامعههای تخصصی دیگری نیز برای علاقهمندان به عاملهای هوش مصنوعی شکل گرفتهاند. این فضاها هم کارکرد شبکه اجتماعی و گفتوگو دارند و هم برای برگزاری کلاس استفاده میشوند. آموزش ساخت عامل با اِناِیتاِن، ارائه پرامپتها، فایلها و منابع کلاس و همچنین موضوعاتی مانند کار با کلاد، وایبکدینگ (Vibe Coding) و ساخت عامل، از جمله محورهای مطرحشدهاند.
یک پروژه آموزشی رایگان نیز فرایند تبدیل یکی از ایدههای پیشنهادشده از سوی مخاطبان به یک کسبوکار واقعی را مستند کرده است. در آن پروژه، ایده از صفر با کمک هوش مصنوعی و عاملها توسعه یافته، به درآمد رسیده و در پایان به فرد پیشنهاددهنده ایده تحویل داده شده است. مستندسازی تمام مراحل، این تجربه را به یک دوره آموزشی عملی تبدیل کرده است.
جمعبندی؛ آیندهای متشکل از چند مدل تخصصی
جِو نشان میدهد که آینده سامانههای هوشمند الزاماً به معنای استفاده از یک مدل بزرگ برای انجام همه کارها نیست. مدلهای زبانی مکالمهای در تولید، توضیح و استدلال متنی قدرتمندند، اما برای هر تصمیم سادهای بهینه نیستند. در سوی دیگر، موتورهای تصمیمگیری ساختاریافته میتوانند با تأخیر بسیار کم، هزینه ناچیز و خروجی قابلاتکا برای کد، وظایف محدود اما پرتکرار را انجام دهند.
این مدل متن آزاد تولید نمیکند، اما همین سکوت مزیت اصلی آن است. نبود متن به معنای نبود هزینه خروجی، حذف مشکلات قالببندی پاسخ و کاهش زمینه شکلگیری توهم متنی است. پردازش موازی پرسشها، پاسخ در حدود ۷۰ تا ۵۰۰ میلیثانیه، امکان رسیدن به تأخیر زیر ۱۰۰ میلیثانیه در نمونه بازی، هزینه ۴۲ سنت برای ۱۰ میلیون توکن ورودی و ارائه درصد اطمینان، جِو را به ابزاری جدی برای طبقهبندی و تصمیمگیری تبدیل میکنند.
با این همه، نباید آن را جایگزین چتجیپیتی، کلاد یا هوش انسانی دانست. بهترین معماری، ترکیبی است: جِو تصمیمهای سریع و ساختاریافته را بگیرد، کد مسیر گردشکار را کنترل کند و مدلهای زبانی بزرگ فقط در نقاطی وارد شوند که واقعاً به زبان، توضیح، خلاقیت یا استدلال گسترده نیاز است. چنین تقسیم کاری میتواند نسل تازهای از عاملها و اتوماسیونها را بسازد که هم سریعترند، هم ارزانتر و هم برای استفاده در محیطهای واقعی قابلکنترلتر.


دیدگاه خود را ثبت کنید
تمایل دارید در گفتگوها شرکت کنید؟در گفتگو ها شرکت کنید.